
دليل استنساخ الصوت بالذكاء الاصطناعي مجانا
استنساخ الصوت بالذكاء الاصطناعي مجانا عبر Chatterbox وOpenVoice V2، بالإضافة إلى ElevenLabs Starter بـ $6/شهريا كأرخص خيار مدفوع يعمل فعلا.
اقرأ المقال →
وصلت تقنية استنساخ الصوت إلى نقطة حيث يمكنك إنشاء نسخة مقنعة من صوتك (أو أي صوت بإذن) واستخدامها لتوليد محتوى صوتي. لصانعي البودكاست، هذا يعني تحرير الأخطاء دون إعادة التسجيل، وإنشاء سرد متسق، أو حتى إنتاج محتوى بلغات لا تتحدثها.
استنسخت صوتي على ElevenLabs لأسمع كيف يصمد، ووضعت الأدوات الثلاث جنبًا إلى جنب من حيث مجانية الوصول الحقيقية وحدود الاستنساخ وشروط الترخيص.
| الأداة | الأفضل لـ | السعر | التقييم | الميزة الرئيسية |
|---|---|---|---|---|
| الأعلى تقييماً ElevenLabs | صانعي البودكاست الذين يدفعون مقابل أعلى جودة | مجاني (دون استنساخ)؛ الاستنساخ من $6/شهر | استنساخ فوري (Instant Voice Clone) من نحو 10 ثوانٍ من الصوت | |
| أفضل قيمة Chatterbox | كل من يريد الاستنساخ مجانًا دون تسجيل | مجاني (MIT)؛ العرض: دقيقتان من وقت GPU يوميًا، و5 دقائق بحساب مجاني | يستنسخ من نحو 5 ثوانٍ؛ عرض للإنجليزية وآخر لـ 23 لغة | |
| استنساخ صوتك بست لغات مجانًا | مجاني (MIT)؛ عرض على CPU دون حصة يومية | يقرأ نصًا بلغة لم تُستخدم في عينتك |
تضيف خطة ElevenLabs Starter بـ $6/شهر ميزة Instant Voice Cloning وترخيصًا تجاريًا. المستوى المجاني يتيح لك تجربة الأصوات المحددة مسبقًا أولًا.
يرشدك الدليل المجاني خطوة بخطوة إلى استخدام Chatterbox وOpenVoice V2 على عروضهما الرسمية في Hugging Face.
ElevenLabs يعتبر على نطاق واسع المعيار الذهبي لتوليف الصوت بالذكاء الاصطناعي. الجودة طبيعية بشكل ملحوظ، مع انعكاس عاطفي مناسب وأنماط كلام واقعية.
لاستنساخ صوتك على ElevenLabs، تحتاج إلى خطة Starter ($6/شهر) التي تتضمن:
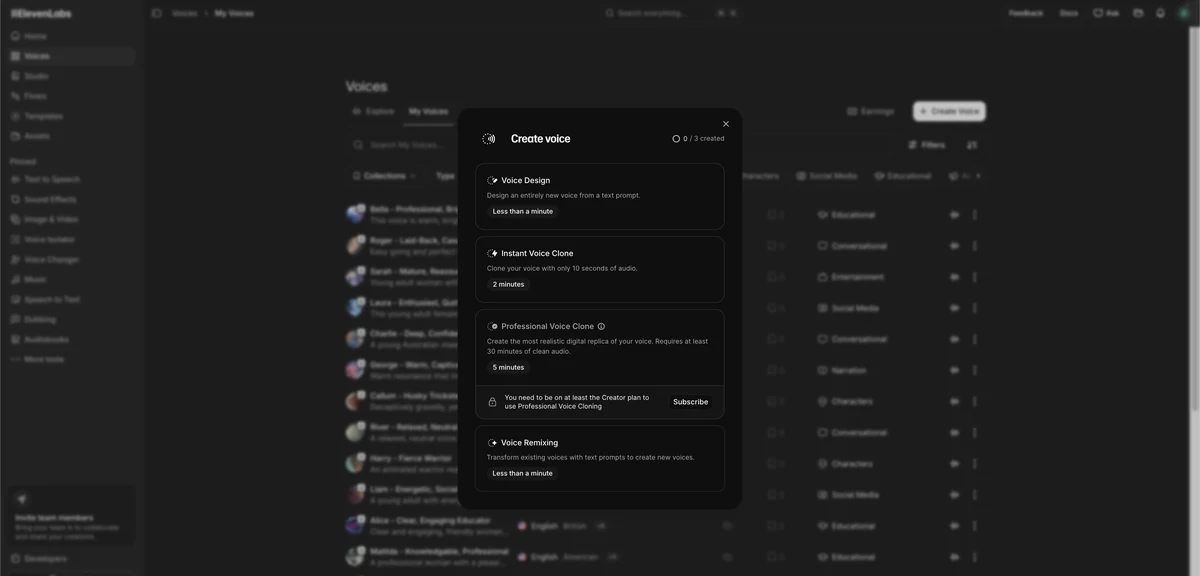
الحكم: ElevenLabs ينتج أفضل جودة، لكن المستخدمين المجانيين لا يمكنهم استنساخ صوتهم الخاص. لصانعي البودكاست المستعدين للدفع، إنه الخيار الأول.
الأفضل لـ: صانعي البودكاست المستعدين لدفع $6/شهر مقابل الاستنساخ الأكثر طبيعية.
Chatterbox نموذج استنساخ صوت مفتوح المصدر من Resemble AI، صدر بترخيص MIT. هذا يجعله مجانيًا للاستخدام الشخصي والبحثي والتجاري، لا نسخة تجريبية تنتهي صلاحيتها. يستنسخ الصوت بلا تدريب مسبق من مقطع قصير، ويعمل العرض الرسمي على Hugging Face داخل المتصفح دون حساب أو تثبيت. الشرح خطوة بخطوة موجود في دليل استنساخ الصوت بالذكاء الاصطناعي المجاني.
لا توجد خطوة تدريب، لذا يصبح الاستنساخ جاهزًا بمجرد أن ينتهي توليد الصوت. وللعربية أو أي لغة أخرى من اللغات الـ 23 التي يدعمها، يعمل العرض الرسمي لـ Chatterbox Multilingual بالطريقة نفسها بعد اختيار اللغة.

عينة قصيرة بلا تدريب مسبق تعطي استنساخًا يسهل التعرف عليه وصالحًا للاستخدام، وهو كافٍ للمشاريع الشخصية والاختبارات السريعة والمحتوى الذي لا يتطلب كمالًا. لن يضاهي نموذجًا مدربًا احترافيًا على ساعات من الصوت، وثباته أقل من الاستنساخ المدرب. في اختبار أعمى نشرته Resemble AI نفسها، فضّل 63.75% من المستمعين Chatterbox على ElevenLabs، وتتناول مقارنتي بين ElevenLabs وChatterbox هذا الادعاء بالتفصيل.
الحكم: Chatterbox هو الخيار لصانعي البودكاست الذين يريدون الاستنساخ دون دفع. ترخيص MIT، واستخدام تجاري مسموح، وخمس ثوانٍ من الصوت. انتقل إلى ElevenLabs عندما تحتاج إلى استنساخ مدرب وسير عمل مصقول.
للحصول على أفضل نتيجة من Chatterbox، ارفع نحو 5 ثوانٍ من كلام نظيف دون ضوضاء خلفية أو موسيقى. مقطع قصير ونظيف أفضل من مقطع طويل تشوبه الضوضاء.
الأفضل لـ: كل من يريد استنساخًا مجانيًا من بضع ثوانٍ من الصوت، داخل المتصفح مباشرة.
OpenVoice V2 نموذج مفتوح المصدر لاستنساخ الصوت، طوّرته MyShell مع باحثين من MIT، وهو متاح بترخيص MIT منذ أبريل 2024، لذا فالاستخدام التجاري مسموح. ومثل Chatterbox، يستنسخ الصوت بلا تدريب مسبق من مقطع قصير، ويعمل عرضه الرسمي على Hugging Face داخل المتصفح دون تسجيل.
يستطيع OpenVoice V2 أن يستنسخ صوتًا من عينة إنجليزية ثم يقرأ به نصًا يابانيًا أو إسبانيًا، دون أن تعيد التسجيل باللغة الجديدة. لهذا فهو خيار مجاني لصانعي البودكاست الذين ينشرون بأكثر من لغة.

عينة قصيرة بلا تدريب مسبق تعطي استنساخًا يسهل التعرف عليه، كما في Chatterbox: يصلح للمقاطع القصيرة والمشاريع الشخصية، مع عيوب صغيرة في النبرة والإيقاع يتجنبها الاستنساخ المدرَّب.
الحكم: OpenVoice V2 خيار مجاني آخر عندما تحتاج إلى صوتك بالإسبانية أو الفرنسية أو الصينية أو اليابانية أو الكورية، ويعمل عرضه على CPU، فلا يُحتسب من حصة GPU اليومية. أما للعمل بالإنجليزية وحدها، فـ Chatterbox Turbo أبسط.
الأفضل لـ: صانعي البودكاست الذين يحتاجون إلى صوتهم المستنسخ بالإسبانية أو الفرنسية أو الصينية أو اليابانية أو الكورية.
لتجربة عملية لا تكلفك شيئًا، يشرح دليل استنساخ الصوت بالذكاء الاصطناعي المجاني طريقة الاستنساخ باستخدام Chatterbox وOpenVoice قبل الالتزام بخطة مدفوعة.
| الجانب | ElevenLabs | Chatterbox | OpenVoice V2 |
|---|---|---|---|
| الصوت المطلوب | من 10 ثوانٍ إلى دقيقتين (Instant) | نحو 5 ثوانٍ | مقطع قصير واحد |
| الاستخدام التجاري | الخطط المدفوعة | نعم نعم (ترخيص MIT) | نعم نعم (ترخيص MIT) |
| مكان التشغيل | تطبيق ElevenLabs على الويب | عرض Hugging Face أو استضافة ذاتية | عرض Hugging Face أو استضافة ذاتية |
| تكلفة الاستنساخ | من $6/شهر (Starter) | مجاني | مجاني |
| الأداة | المستوى المجاني | خطة Starter | الخطة التالية |
|---|---|---|---|
| ElevenLabs | 10K حرف | $6/شهر (30K حرف) | $22/شهر لخطة Creator (100K) |
| Chatterbox | مجاني (ترخيص MIT) | لا يوجد (مفتوح المصدر) | لا يوجد (شغّله ذاتيًا للحجم الكبير) |
| OpenVoice V2 | مجاني (ترخيص MIT) | لا يوجد (مفتوح المصدر) | لا يوجد (شغّله ذاتيًا للحجم الكبير) |
Chatterbox مجاني وبترخيص MIT. وعندما تريد استنساخًا أكثر طبيعية وسير عمل أكثر صقلًا، فخطة ElevenLabs Starter بـ $6/شهر.
استنسخ صوتك مع ElevenLabs →استنساخ الصوت يثير أسئلة أخلاقية مهمة:
معظم المنصات تتطلب التحقق من أنك تملك أو لديك إذن لاستنساخ صوت.
ابدأ مع Chatterbox. إنه مجاني وبترخيص MIT يتيح الاستخدام التجاري، ويستنسخ من نحو خمس ثوانٍ من الصوت على عرض Hugging Face الرسمي. الجودة جيدة بما يكفي للمشاريع الشخصية والمقاطع القصيرة التي لا تتطلب كمالًا.
استثمر في ElevenLabs إذا كانت جودة الصوت مهمة لعلامتك التجارية. إنه الأقرب إلى عدم إمكانية التمييز عن الكلام البشري، ويبدأ الاستنساخ من خطة Starter بـ $6/شهر.
لأكثر من لغة دون ميزانية. إنه بترخيص MIT، ويستطيع قراءة نص بالإسبانية أو الفرنسية أو الصينية أو اليابانية أو الكورية بصوت مستنسخ من عينة إنجليزية.
نعم، استنساخ صوتك الخاص قانوني. استنساخ أصوات الآخرين يتطلب موافقتهم الصريحة. استخدام الأصوات المستنسخة للاحتيال أو الانتحال أو نشر معلومات مضللة قد يكون غير قانوني. احصل دائمًا على إذن واكشف عن استخدام الذكاء الاصطناعي.
يتراوح من نحو 5 ثوانٍ إلى عدة ساعات. أدوات الاستنساخ بلا تدريب مسبق مثل Chatterbox تعمل من نحو 5 ثوانٍ من الصوت النظيف، وتوصي ميزة Instant Voice Cloning من ElevenLabs بدقيقة إلى دقيقتين، بينما يحتاج الاستنساخ بجودة احترافية من 30 دقيقة إلى 3 ساعات. الصوت النظيف دون ضوضاء خلفية أهم من طوله.
يعتمد ذلك على المنصة والخطة. Chatterbox وOpenVoice V2 بترخيص MIT، لذا الاستخدام التجاري مسموح دون تكلفة. المستوى المجاني لـ ElevenLabs لا يسمح بالاستخدام التجاري؛ الخطط المدفوعة تسمح به. تحقق دائمًا من الشروط المحددة للترخيص التجاري.
الاستنساخات الحديثة يمكن أن تكون دقيقة بشكل ملحوظ. ElevenLabs لا يمكن تمييزه تقريبًا في الجودة. Chatterbox وOpenVoice V2 ينتجان استنساخات يسهل التعرف عليها وصالحة للاستخدام، وقد تكون قابلة للكشف عند الاستماع عن قرب. الجودة تعتمد على الصوت المصدر والمنصة.
نعم، معظم المنصات تدعم عدة لغات. ElevenLabs يدعم 29 لغة من استنساخ واحد. نموذج Chatterbox Multilingual يغطي 23 لغة، أما OpenVoice V2، وهو نموذج مفتوح المصدر مستقل، فيدعم أصلًا الإنجليزية والإسبانية والفرنسية والصينية واليابانية والكورية. يمكنك إنشاء محتوى بلغات لا تتحدثها باستخدام صوتك المستنسخ، والذكاء الاصطناعي يتعامل مع النطق.
يعتمد ذلك على ما تحتاج إليه. يستنسخ Chatterbox من نحو 5 ثوانٍ من الصوت، ويعمل على عروض Hugging Face رسمية دون تسجيل: Turbo للإنجليزية، وMultilingual لـ 23 لغة. ويغطي عرض OpenVoice V2 ست لغات ويعمل على CPU، لذا لا يُحتسب من حصة GPU اليومية. وكلا النموذجين بترخيص MIT. أما المستوى المجاني لـ ElevenLabs فلا يتضمن أي استنساخ، ويبدأ الاستنساخ من خطة Starter بـ $6/شهر.
 مميز 12 دقيقة قراءة
استنساخ الصوت بالذكاء الاصطناعي مجانا عبر Chatterbox وOpenVoice V2، بالإضافة إلى ElevenLabs Starter بـ $6/شهريا كأرخص خيار مدفوع يعمل فعلا.
اقرأ المقال → 14 دقيقة قراءة
Chatterbox TTS يفوز في 63٪ من الاختبارات العمياء على ElevenLabs — وهو مجاني. قارِن جودة الصوت والأسعار وزمن الاستجابة واستنساخ الصوت.
اقرأ المقال → 15 دقيقة قراءة
اختبرتُ ElevenLabs و Murf AI و Speechify وقارنتُ Fliki لعام 2026. مقارنة استنساخ الصوت والجودة والأسعار من $6/شهر.
اقرأ المقال → 13 دقيقة قراءة
مقارنة أفضل أدوات تحويل النص إلى كلام في 2026: ElevenLabs وMurf AI وSpeechify وSynthesys في جودة الصوت والسعر من $6 شهرياً والخطط المجانية.
اقرأ المقال →