
مراجعة ElevenCreative 2026
يمنحك ElevenCreative 10,000 رصيد مجاني شهرياً، ثم من $6 إلى $99. مراجعة لـ Studio وFlows وMusic v2 وDubbing v2، وأين تكمن مشكلة استهلاك الأرصدة.
اقرأ المقال →
توليد الأصوات بالذكاء الاصطناعي يحوّل النص المكتوب إلى كلام منطوق عبر نماذج عصبية، بينما يجعل استنساخ الصوت هذا الكلام يشبه صوت شخص بعينه. في 2026 يقدّم ElevenLabs أكثر الأصوات طبيعية من $5 شهرياً على الفوترة السنوية ($6 شهرياً) ويستنسخ صوتاً من أقل من دقيقة من التسجيل، ويناسب Murf Studio الفرق التي تنتج تعليقات صوتية للتدريب والعروض التقديمية من $19 شهرياً على الفوترة السنوية ($29 شهرياً)، بينما يبقى Speechify الخيار الأنسب للاستماع إلى المستندات لا لإنتاج السرد.
مناسب بشكل رائع لـ: معلمي المنتجات، فرق البودكاست، قادة دعم العملاء، والمؤثرين الذين يريدون توسيع نطاق السرد دون حرق ساعات الاستوديو.
مولد الصوت بالذكاء الاصطناعي تقنية تحوّل النص المكتوب إلى كلام منطوق عبر شبكات عصبية مدرّبة على تسجيلات بشرية. ينقسم المجال إلى فئتين: تحويل النص إلى كلام بأصوات جاهزة، واستنساخ الصوت الذي يبني نموذجاً مخصصاً من عيّنة تبدأ من 5 ثوانٍ على النماذج مفتوحة المصدر وتصل إلى 3 ساعات في الاستنساخ الاحترافي.
على عكس الأصوات الآلية الرتيبة للكمبيوتر في الماضي، تستفيد أصوات الذكاء الاصطناعي الحديثة من التعلم العميق لإنتاج كلام طبيعي بشكل ملحوظ يشبه البشر مع التنغيم والعاطفة والإيقاع المناسبين.
تتضمن تقنية أصوات الذكاء الاصطناعي اليوم فئتين رئيسيتين:
تحويل النص إلى كلام (TTS): تحويل النص المكتوب إلى كلمات منطوقة باستخدام نماذج أصوات الذكاء الاصطناعي المدربة مسبقاً. تكتب النص، تختار صوتاً، وتولد الصوت فوراً.
استنساخ الصوت: إنشاء نموذج صوتي مخصص بالذكاء الاصطناعي يكرر صوت شخص معين. بعد التدريب على عينات الصوت، التي قد تكون بضع ثوانٍ على النماذج مفتوحة المصدر وتصل إلى ساعات قليلة في الاستنساخ الاحترافي، يمكن للذكاء الاصطناعي التحدث بأي نص بصوت ذلك الشخص.
تحسنت الجودة كثيراً. استمع بعناية وستظل تلاحظ الفرق، لكن في الكتب الصوتية والتعلم الإلكتروني وسرد الفيديو والبودكاست يقبل معظم الجمهور النتيجة.
لأن التكلفة والوقت يتغيران جذرياً. يتقاضى الممثل الصوتي المحترف من $200 إلى $500 لكل ساعة منتهية، بينما تكلّف باقات توليد الصوت التي يختارها معظم صانعي المحتوى من $5 إلى $99 شهرياً. أضف إلى ذلك أكثر من 70 لغة على نموذج v3 من ElevenLabs، وإمكانية تحديث أي مقطع دون إعادة تسجيل.
تعمل الأصوات الحديثة على شبكات عصبية تمر بأربع مراحل: تحليل النص، تحويله إلى فونيمات، نمذجة الإيقاع والنبرة، ثم توليف الموجة الصوتية. يضيف الاستنساخ مرحلة خامسة هي أخذ العينة، وتتراوح من نحو 5 ثوانٍ على النماذج مفتوحة المصدر إلى 3 ساعات للاستنساخ الاحترافي.
تستخدم أصوات الذكاء الاصطناعي الحديثة الشبكات العصبية المدربة على مجموعات بيانات ضخمة من الكلام البشري. إليك العملية المبسطة:
تحليل النص: يحلل الذكاء الاصطناعي نصك لفهم:
التحويل الصوتي: يتم تحويل النص إلى الفونيمات (أصوات الكلام الأساسية)
نمذجة الإيقاع: يحدد الذكاء الاصطناعي:
توليف الصوت: تولد الشبكات العصبية شكل الموجة الصوتية الفعلية التي تبدو مثل الكلام البشري
يذهب استنساخ الصوت إلى أبعد من ذلك، حيث ينشئ نموذج صوت مخصص:
أخذ عينات الصوت: سجل الصوت المستهدف (من نحو 5 ثوانٍ على النماذج مفتوحة المصدر بلا تدريب مسبق إلى 3 ساعات للاستنساخ الاحترافي)
استخراج الميزات: يحلل الذكاء الاصطناعي التسجيل للخصائص الفريدة:
تدريب النموذج: تتعلم الشبكة العصبية تكرار الصوت
التوليف: يمكن للنموذج المدرب التحدث بأي نص بالصوت المستنسخ
ثلاث أدوات تغطي معظم الاحتياجات: ElevenLabs للسرد الأكثر طبيعية من $6 شهرياً، وMurf Studio لتعليقات الفرق الصوتية من $29 شهرياً، وSpeechify للاستماع إلى المستندات من $29 شهرياً. الجدول أدناه يوضح الفروق في الباقة المجانية وأرخص باقة مدفوعة وإمكانية استنساخ الصوت، ثم تأتي تفاصيل كل أداة بعده.
الباقات والأسعار مقروءة من صفحة أسعار كل مزوّد في سبتمبر 2026.
| الأداة | الباقة المجانية | أرخص باقة مدفوعة | استنساخ الصوت | الأنسب لـ |
|---|---|---|---|---|
| ElevenLabs | 10,000 رصيد شهرياً (نحو 10 دقائق)، بلا ترخيص تجاري | Starter بـ $6 شهرياً أو $5 على الفوترة السنوية | استنساخ فوري على Starter، واستنساخ احترافي على Creator ($22 شهرياً) | السرد والكتب الصوتية وYouTube وكل ما تهم فيه الطبيعية |
| Murf Studio | 10 دقائق مرة واحدة، دون تنزيل ودون حقوق تجارية | Creator بـ $29 شهرياً أو $19 على الفوترة السنوية | على باقة Enterprise فقط، ومن ساعة إلى ساعتين من تسجيلات الاستوديو | التعليقات الصوتية الجماعية للتدريب والعروض التقديمية والتعلم الإلكتروني |
| Speechify | أصوات أساسية حتى سرعة 1.5x | Premium بـ $29 شهرياً أو $139 سنوياً | ليس محور المنتج | الاستماع إلى المستندات وملفات PDF وصفحات الويب |
الأفضل لـ: أكثر الأصوات طبيعية؛ الكتب الصوتية وسرد YouTube والبودكاست والمحتوى الطويل
نقاط القوة:
التسعير: المحاسبة بالأرصدة لا بالدقائق: رصيد واحد لكل حرف على نموذج Multilingual v2، ومن 0.5 إلى رصيد واحد لكل حرف على نموذجي Flash وTurbo عبر API.
الاستخدامات المثالية: الكتب الصوتية، البودكاست، سرد YouTube، مقالات الفيديو، التعلم الإلكتروني
الأفضل لـ: الفرق التي تنتج فيديوهات التدريب والعروض التقديمية والتعلم الإلكتروني؛ تعليقات صوتية متسقة مع العلامة التجارية
نقاط القوة:
التسعير: المحاسبة بالساعات لا بالأرصدة.
الاستخدامات المثالية: العروض التقديمية للشركات، فيديوهات الشرح، وحدات التدريب، الإعلانات
الأفضل لـ: قراءة المستندات وملفات PDF وصفحات الويب والكتب بصوت عالٍ، مع تطبيقات محمولة وإضافة للمتصفح
نقاط القوة:
التسعير:
الاستخدامات المثالية: الإنتاجية الشخصية، إمكانية الوصول، الدراسة
إذا أردت استخدام Speechify للسرد بدلاً من الاستماع، يشرح دليل التعليق الصوتي على Speechify هذا الإعداد خطوة بخطوة.
يدمج Descript أصوات الذكاء الاصطناعي واستنساخ صوت من نحو دقيقة من التسجيل داخل محرره الصوتي والمرئي القائم على النص، وهو خيار منطقي إذا كنت تحرّر البودكاست هناك أصلاً. أما Chatterbox وOpenVoice V2 فنموذجان مفتوحا المصدر يستنسخان الصوت من نحو خمس ثوانٍ ويعملان على عتادك مجاناً؛ فضّل 63.75% من المستمعين Chatterbox على ElevenLabs في اختبار أعمى، وهو ما يغطيه دليل استنساخ الصوت مجاناً ومقارنة ElevenLabs وChatterbox. ولقائمة أطول، راجع أفضل مولدات الصوت بالذكاء الاصطناعي وأفضل أدوات تحويل النص إلى كلام.
التوصية: ElevenLabs لأفضل نسبة جودة إلى سعر ولباقتها المجانية السخية، وMurf Studio لإنتاج العروض التقديمية والتدريب داخل الفرق، وSpeechify إذا كنت تريد الاستماع أكثر مما تريد النشر.
تمنحك الباقة المجانية 10 دقائق من التوليد لتجربة أكثر من 200 صوت والمحرر نفسه. التنزيلات والحقوق التجارية تبدأ من باقة Creator بـ $19 شهرياً على الفوترة السنوية.
جرّب Murf AI مجاناً ←بست خطوات: جهّز النص بعلامات ترقيم صحيحة، اختر الصوت بعد تجربة 3 إلى 5 أصوات على مقطع من 100 إلى 200 كلمة، اضبط السرعة والتوقفات، صحّح النطق، ولّد الصوت واستمع إليه كاملاً، ثم عالج الملف معالجة خفيفة قبل التصدير. الخطوات مفصّلة أدناه.
تعمل أصوات الذكاء الاصطناعي بشكل أفضل مع نص معد جيداً: علامات ترقيم صحيحة، نبرة محادثة، وتهجئة صوتية للكلمات الصعبة.
تعمل أصوات الذكاء الاصطناعي بشكل أفضل مع النص المعد جيداً. اتبع هذه الإرشادات:
تنسيق السيناريو:
جيد: "مرحباً بك في هذا البرنامج التعليمي. اليوم، نستكشف توليد أصوات الذكاء الاصطناعي."

سيء: "مرحباً بك في هذا البرنامج التعليمي اليوم نستكشف توليد أصوات الذكاء الاصطناعي"
المبادئ الأساسية:
افعل:
لا تفعل:
مثال على السيناريو:
قبل:
"توليد أصوات الذكاء الاصطناعي أحدث ثورة في إنتاج المحتوى مما يسمح للمبدعين بإنتاج كتب صوتية بودكاست وفيديوهات دون ممثلين صوتيين مكلفين أو معدات تسجيل لقد غير كل شيء"

بعد:
"توليد أصوات الذكاء الاصطناعي أحدث ثورة في إنتاج المحتوى.

يسمح للمبدعين بإنتاج كتب صوتية، بودكاست، وفيديوهات... دون ممثلين صوتيين مكلفين أو معدات تسجيل.

لقد غير كل شيء."طابق الصوت مع نوع المحتوى والجمهور والعلامة التجارية، ثم اختبر عدة أصوات قبل الالتزام بواحد.
يؤثر اختيار الصوت في كيفية استقبال رسالتك.
معايير اختيار الصوت:
1. تطابق نوع المحتوى:
2. ضع في الاعتبار التركيبة السكانية:
3. محاذاة العلامة التجارية:
اختبار الأصوات:
تتيح معظم المنصات معاينة الأصوات. استخدم هذه العملية:
تضم مكتبة ElevenLabs أكثر من 10,000 صوت يمكنك تصفيتها حسب اللغة وحالة الاستخدام والأسلوب. ويضم منتقي الأصوات في Murf Studio أكثر من 200 صوت مع مرشّحات حسب حالة الاستخدام، وأصوات MultiNative فيه تبدّل اللغة في منتصف النص.

اضبط السرعة والنبرة والتوقفات والمشاعر عبر أدوات كل منصة بدلاً من SSML الكامل.
تقدم أدوات أصوات الذكاء الاصطناعي الحديثة عناصر تحكم لضبط تقديم الكلام:
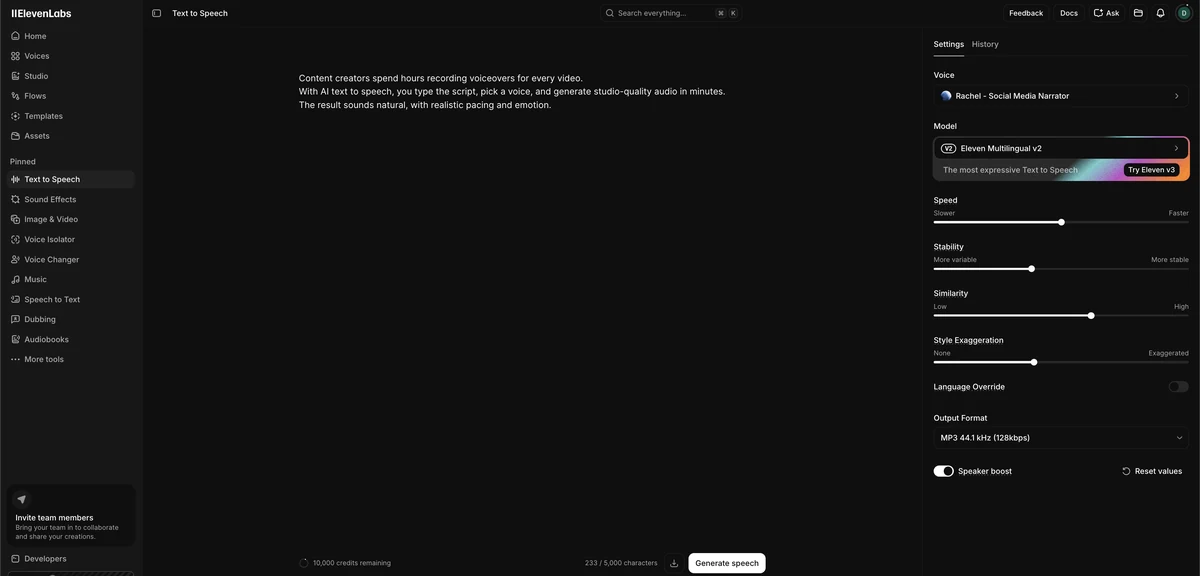
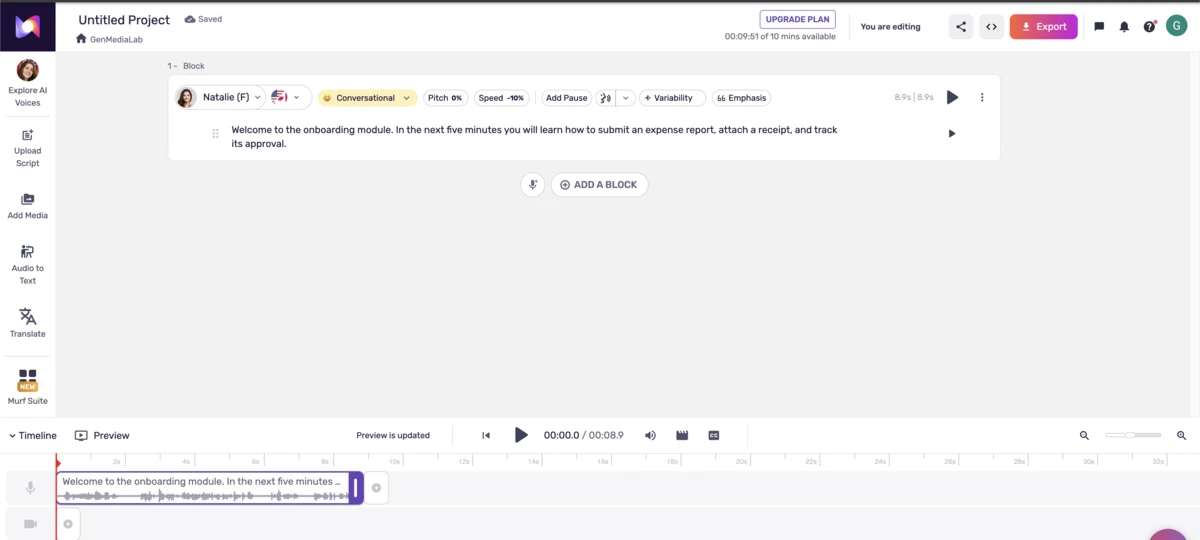
أسماء عناصر التحكم: تضم لوحة إعدادات ElevenLabs مؤشرات Speed وStability وSimilarity وStyle Exaggeration ومفتاح Speaker Boost، إضافة إلى اختيار النموذج (Multilingual v2 أو v3). أما Murf Studio فيمنحك سرعة ونبرة لكل مقطع نصي، وتوقفات، وعلى باقة Business ميزات Emphasis وVariability وSay It My Way، حيث تسجّل قراءتك أنت للجملة فينسخ الصوت إيقاعك وتنغيمك.
السرعة/الإيقاع:
النبرة:
التوقفات: علامات الترقيم أولاً: الفواصل (قصيرة)، النقاط (متوسطة)، فواصل الفقرات (طويلة). على نماذج v2 من ElevenLabs، أضف <break time="1.5s" /> لتوقف ثابت يصل إلى 3 ثوانٍ؛ ونموذج v3 لا يدعم وسوم break، فاستخدم علامات الترقيم وعلامات الحذف هناك. وفي Murf Studio، اكتب [pause 1s] بين الكلمات لتوقف من 0.1 إلى 5 ثوانٍ.
العاطفة: يقرأ نموذج v3 من ElevenLabs وسوماً صوتية بين أقواس مربعة مثل [excited] و[whispers] و[sarcastic] و[crying]. أما Murf فيمنح كل صوت مجموعة من الأساليب (محادثة، ترويجي، وغيرها) بدلاً من الوسوم.
تخطئ أصوات الذكاء الاصطناعي أحياناً في النطق، فاستخدم التهجئة الصوتية أو أدوات النطق في منصتك لتصحيحها.
أحياناً تنطق أصوات الذكاء الاصطناعي الكلمات بشكل خاطئ. إليك كيفية إصلاحها:
التهجئة الصوتية:
إذا قال الذكاء الاصطناعي “data” كـ “day-ta” لكنك تريد “dah-ta”:
مشاكل النطق الشائعة:
| الكلمة | الافتراضي في الذكاء الاصطناعي | الإصلاح الصوتي |
|---|---|---|
| GIF | ”jif” أو “gif” | اكتبها: “G-I-F” |
| SQL | ”sequel” أو “S-Q-L” | اختر صوتي: “sequel” أو “ess-cue-ell” |
| URL | ”ural” أو “U-R-L” | استخدم: “U-R-L” أو “عنوان ويب” |
| Data | يختلف | ”dah-ta” أو “day-ta” |
نطق الأسماء:
للأسماء الصعبة، استخدم التهجئة الصوتية:
أدوات خاصة بالمنصة:
<phoneme> على نموذج Flash v2 (أبجدية CMU Arpabet هي الأكثر قابلية للتنبؤ)؛ وعلى v3 اكتب النسخ الصوتي بأبجدية IPA بين شرطتين مائلتين داخل النص مباشرة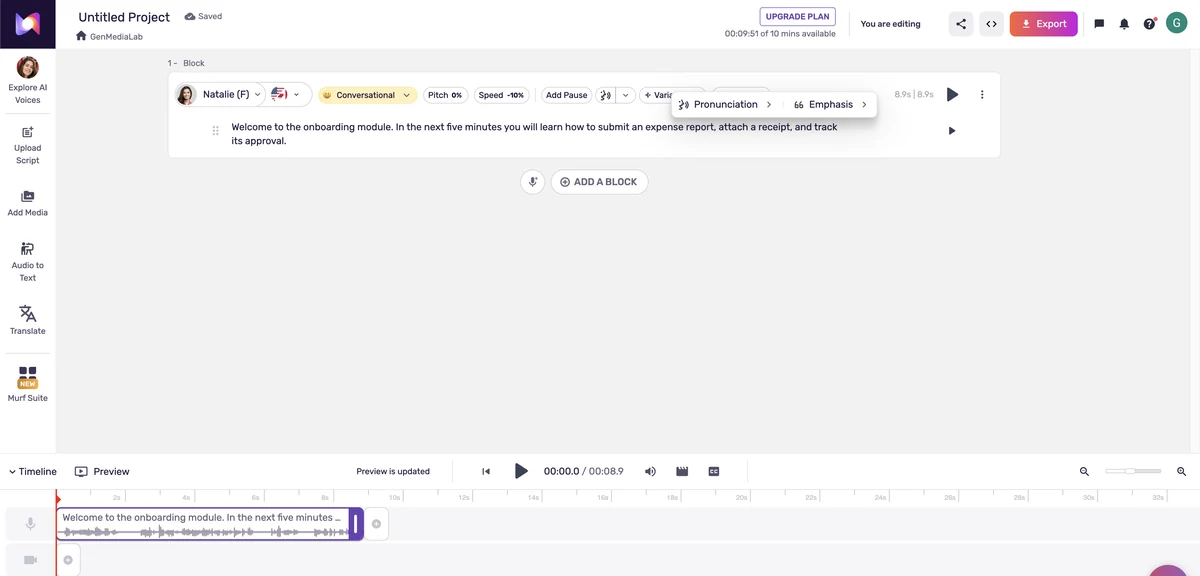
راجع قائمة التحقق قبل التوليد، ولّد الصوت، ثم استمع إليه بعناية بحثاً عن الأخطاء قبل النشر.
حان الوقت لإنشاء صوتك:
1. قائمة التحقق النهائية قبل التوليد:
2. توليد الصوت:
تُخرج ElevenLabs ملفات MP3 بتردد 44.1 kHz ومعدل 128 kbps على الباقات القياسية، مع 192 kbps وPCM بتردد 44.1 kHz عبر API على باقة Pro. ويصدّر Murf Studio بصيغ MP3 وWAV وFLAC وفيديو، لكن على الباقات المدفوعة فقط، لأن الباقة المجانية لا تسمح بالتنزيل.
3. مراجعة الاستماع النقدي:
استمع بأذن جديدة (خذ استراحة قبل المراجعة إن أمكن):
استمع لـ:
تقنيات المراجعة:
4. التكرار والتحسين:
إذا وجدت مشاكل:

للنتائج الاحترافية، طبّع الحجم واقصص الصمت وطبّق ضغطاً لطيفاً قبل التصدير.
للنتائج الاحترافية، فكر في معالجة لاحقة خفيفة:
في Audacity (مجاني) أو Adobe Audition (احترافي):
سير عمل معالجة لاحقة بسيط:
ينشئ الاستنساخ نسخة رقمية من صوت بعينه. تحتاج ElevenLabs إلى أقل من دقيقة في الاستنساخ الفوري، ومن 30 دقيقة إلى 3 ساعات في الاستنساخ الاحترافي، ويطلب Murf من ساعة إلى ساعتين من تسجيلات الاستوديو على باقة Enterprise وحدها، بينما تكتفي النماذج مفتوحة المصدر بنحو 5 ثوانٍ.
أسباب جيدة للاستنساخ:
غير موصى به:
الخطوة 1: سجل عينات الصوت
متطلبات التسجيل:
متطلبات الصوت كما توثّقها كل منصة، سبتمبر 2026.
| المنصة | الصوت المطلوب | الباقة | ملاحظات |
|---|---|---|---|
| ElevenLabs Instant Voice Cloning | أقل من دقيقة؛ يُنصح بدقيقة إلى دقيقتين، وأكثر من 3 دقائق قد يضر بالنتيجة | Starter، $6 شهرياً أو $5 على الفوترة السنوية | جاهز خلال دقائق، والنسخة تتحدث كل اللغات المدعومة |
| ElevenLabs Professional Voice Cloning | من 30 دقيقة إلى 3 ساعات | Creator، $22 شهرياً أو $18.33 على الفوترة السنوية | يستغرق التدريب من 3 إلى 6 ساعات تقريباً؛ صوتك أنت فقط، مع تسجيل تحقق |
| Murf Studio | من ساعة إلى ساعتين من تسجيلات الاستوديو | باقة Enterprise فقط، بعرض سعر من فريق المبيعات | لا استنساخ ذاتي الخدمة على Free أو Creator أو Business |
| Chatterbox / OpenVoice V2 (مفتوحة المصدر) | نحو 5 ثوانٍ | مجاني، ويعمل على عتادك | بلا تدريب مسبق (zero-shot): لا خطوة تدريب، واستقرار أقل من نسخة مدرّبة |
البيئة:
المعدات:
تقنية التسجيل:
ماذا تقرأ:
توفر معظم المنصات سيناريوهات مقترحة تغطي جميع الأصوات الصوتية. إذا كنت تنشئ بنفسك:
الخطوة 2: ارفع ومعالج
الخطوة 3: اختبر وصقل
توليد صوت اختبار بمحتوى متنوع
استمع بشكل نقدي لـ:
إذا كانت الجودة غير كافية:
الخطوة 4: استخدم صوتك المستنسخ
بمجرد الرضا، يعمل صوتك المستنسخ مثل أي صوت آخر من أصوات الذكاء الاصطناعي:
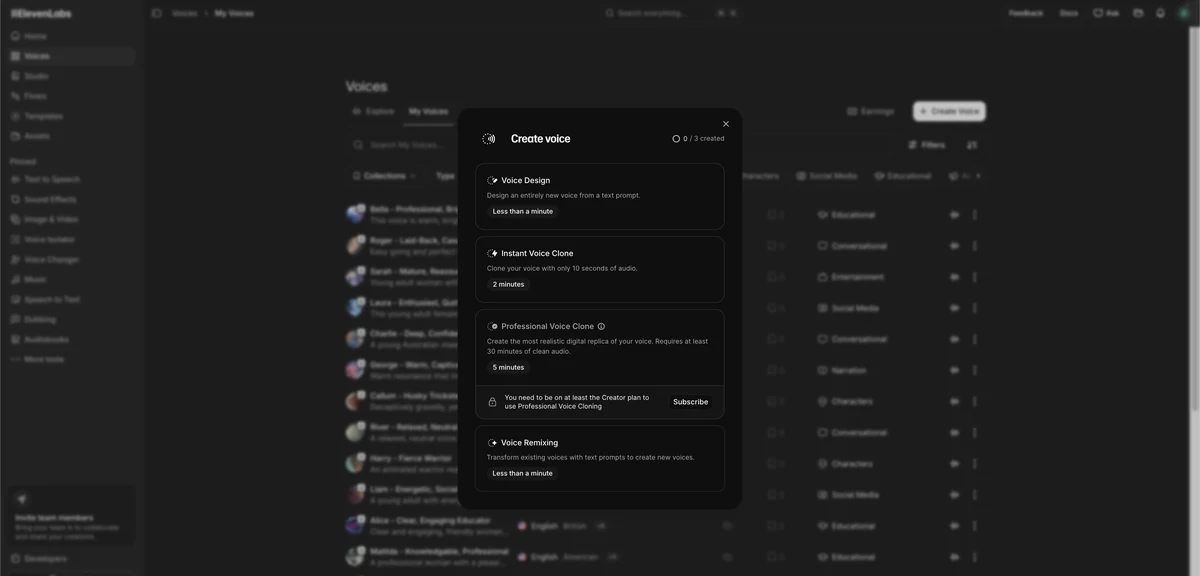
اعتبارات أخلاقية وقانونية: تقنية استنساخ الصوت قوية ويمكن إساءة استخدامها. استنسخ فقط الأصوات التي لديك إذن صريح لاستنساخها. تتطلب العديد من المنصات التحقق من الهوية لاستنساخ الصوت لمنع الاحتيال والـ deepfakes. استخدم أصوات الذكاء الاصطناعي بمسؤولية دائماً وفكر في تضمين إخلاءات المسؤولية عند نشر محتوى صوتي مولّد بالذكاء الاصطناعي.
خمس تقنيات ترفع الجودة: وسوم كل منصة بدلاً من SSML الكامل، والتعديل العاطفي المقتصد، والنصوص متعددة الأصوات، والصمت المتعمّد بين الجمل، ومزج نحو 10% من التسجيل البشري مع 90% من السرد المولّد. لا تحتاج إلى أكثر من ذلك في معظم المشاريع.
تستخدم ElevenLabs وMurf Studio ترميزاً خفيفاً خاصاً بكل منهما بدلاً من SSML الكامل.
| التحكم | ElevenLabs | Murf Studio |
|---|---|---|
| التوقف | <break time="1.5s" /> على نماذج v2، حتى 3 ثوانٍ؛ ونموذج v3 يعتمد على علامات الترقيم وعلامات الحذف | [pause 1s]، من 0.1 إلى 5 ثوانٍ |
| التأكيد | الأحرف الكبيرة وعلامات الترقيم؛ ووسوم صوتية على v3 | أداة Emphasis على مقطع نصي (باقة Business) |
| النطق | قواميس (.PLS أو TXT)، ووسوم <phoneme> على Flash v2، وIPA بين شرطتين مائلتين على v3 | لوحة Pronunciation لكل كلمة؛ والقوائم المحفوظة على Enterprise فقط |
| العاطفة | وسوم صوتية مثل [whispers] و[excited] و[sarcastic] | أساليب صوت لكل صوت؛ وSay It My Way على باقة Business |
| السرعة | شريط تمرير Speed | سرعة لكل مقطع نصي |
أما SSML الكامل بوسوم prosody وsay-as وrate فيخص واجهات الكلام السحابية من Google وAmazon وMicrosoft، وهي منتجات موجهة للمطورين لا محررات.
يقرأ نموذج v3 من ElevenLabs وسوماً صوتية بين أقواس مربعة، بينما يعتمد Murf على أساليب لكل صوت بدلاً منها:
علامات العاطفة:
[excited] هذا هو إطلاق المنتج الأكثر روعة!
[sad] لسوء الحظ، علينا مشاركة بعض الأخبار الصعبة.
[whispers] إليك سراً لا يعرفه أحد بعد.
عاطفة دقيقة:
للحوارات أو المحادثات:
تنسيق الحوار:
[صوت1 - أنثى احترافية]: مرحباً بكم في بودكاستنا!
[صوت2 - ذكر عادي]: شكراً لاستضافتي.
[صوت1 - أنثى احترافية]: دعنا نتعمق في موضوع اليوم.
التطبيقات:
الصمت قوي للفهم:
أين تضيف التوقفات:
مثال:
"زادت إيراداتنا بنسبة 300% في الربع الأخير. [توقف ثانيتين]

دعني أكرر ذلك. [توقف ثانية واحدة] ثلاثمائة. بالمئة.

[توقف 1.5 ثانية] إليك كيف فعلنا ذلك..."اجمع أصوات الذكاء الاصطناعي مع التسجيلات البشرية بشكل استراتيجي:
نهج هجين:
الفوائد:
خمسة مجالات تستفيد أكثر من غيرها: الكتب الصوتية، وسرد YouTube، والتدريب المؤسسي، وإنتاج البودكاست، وعروض المنتجات. كتاب من 60,000 كلمة يكلّف من $3,000 إلى $10,000 بالإنتاج التقليدي، بينما يمكن سرده على باقة Pro من ElevenLabs بـ $99 لشهر واحد أو على ثلاثة أشهر من باقة Creator بـ $22 شهرياً.
التحدي: إنتاج الكتب الصوتية التقليدية يكلف من $3,000 إلى $10,000 لكل كتاب.
حل صوت الذكاء الاصطناعي:
أفضل الممارسات:
التحدي: تتطلب الرفعات المتسقة ساعات من التسجيل والتحرير للتعليقات الصوتية.
حل صوت الذكاء الاصطناعي:
أفضل الممارسات:
التحدي: تحديثات المحتوى المتكررة تجعل التسجيل الصوتي التقليدي غير مستدام.
حل صوت الذكاء الاصطناعي:
أفضل الممارسات:
التحدي: جودة تسجيل غير متسقة، معالجة لاحقة تستغرق وقتاً طويلاً.
حل صوت الذكاء الاصطناعي (Instant Voice Cloning من ElevenLabs):
أفضل الممارسات:
التحدي: إنشاء سرد فيديو احترافي بسرعة لإطلاق المنتج.
حل صوت الذكاء الاصطناعي (Murf Studio):
أفضل الممارسات:
الفارق كبير: كتاب صوتي من 60,000 كلمة يكلّف من $5,300 إلى $12,000 مع ممثل صوتي، ومن $66 إلى $99 بالذكاء الاصطناعي. قناة YouTube بأربعة فيديوهات شهرياً تكلّف من $4,800 إلى $12,000 سنوياً مقابل $220 إلى $228، و50 ساعة من التدريب المؤسسي تكلّف $792.
ممثل صوتي محترف:
صوت الذكاء الاصطناعي (ElevenLabs):
العائد على الاستثمار: توفير تكلفة 98%+
ممثل صوتي محترف:
صوت الذكاء الاصطناعي (ElevenLabs Creator أو Murf Creator):
العائد على الاستثمار: توفير تكلفة 95%+
ممثل صوتي محترف:
صوت الذكاء الاصطناعي (Murf Business):
العائد على الاستثمار: توفير تكلفة 92%+
كلتا الأداتين تفوتران بالدولار الأمريكي، لذا يظهر المبلغ محوّلاً على كشف بطاقتك، والباقات المجانية هي الطريقة العملية لاختبار جودة الأصوات العربية قبل الدفع.
عندما يستحق الممثلون الصوتيون البشر:
عندما تتفوق أصوات الذكاء الاصطناعي:
ثمانية أخطاء تتكرر: صوت لا يناسب المحتوى، وإيقاع بلا توقفات، ونطق خاطئ يمر دون مراجعة، وإفراط في التأكيد، واختيار صوت من عينة مدتها 10 ثوانٍ، وتجاهل جهاز الاستماع، وإهمال المعالجة اللاحقة، واستخدام صوت مولّد حيث يلزم صوت بشري. الحل في كل حالة أبسط مما يبدو.
الخطأ: اختيار صوت نشط وعادي لمحتوى تدريب طبي
الحل: طابق رسمية الصوت وطاقته ونبرته مع محتواك وجمهورك
الخطأ: ربط الجمل معاً دون مساحة للتنفس
الحل: استخدم علامات الترقيم بشكل متعمد؛ أضف توقفات مع علامات الحذف أو فواصل الفقرات
الخطأ: نشر محتوى مع مصطلحات رئيسية نطقها خاطئ
الحل: استمع إلى 100% من الصوت المولد؛ استخدم التهجئة الصوتية للكلمات الصعبة
الخطأ: التأكيد على كل كلمة أخرى يجعل لا شيء يبرز
الحل: احتفظ بالتأكيد للنقاط الحرجة حقاً؛ دع التقديم الطبيعي يحمل معظم المحتوى
الخطأ: اختيار صوت بناءً على عينة 10 ثوانٍ، ثم اكتشاف المشاكل بعد توليد ساعات
الحل: اختبر الأصوات بفقرات كاملة من محتواك الفعلي قبل الالتزام
الخطأ: إنشاء صوت يعمل مع السماعات لكن ليس مع مكبرات صوت الكمبيوتر المحمول
الحل: اختبر على أجهزة متعددة؛ تأكد من الوضوح عبر سيناريوهات التشغيل
الخطأ: نشر صوت خام مولّد بالذكاء الاصطناعي مع بدايات/نهايات قاسية
الحل: تحرير خفيف في Audacity: قص الصمت، طبيع الحجم، صقل الحواف الخشنة
الخطأ: صوت الذكاء الاصطناعي لسرد عاطفي يتطلب اتصال بشري أصيل
الحل: افهم القيود؛ استخدم أصوات بشرية حيث العاطفة الحقيقية مهمة
أربع قواعد: أفصح عن الصوت المولّد في المحتوى الموجّه للجمهور، ولا تستنسخ صوت أحد دون إذن كتابي، وتحقق من ترخيص باقتك قبل النشر. الباقة المجانية في ElevenLabs بلا ترخيص تجاري، والترخيص يبدأ من باقة Starter بـ $6 شهرياً، أما حقوق Murf التجارية فتبدأ من باقة Creator.
متى تكشف عن أصوات الذكاء الاصطناعي:
أمثلة الإفصاح:
لا تستنسخ صوتاً أبداً دون:
التحقق من المنصة:
افهم الترخيص:
الاستخدامات الإيجابية:
أفضل الممارسات:
معظم ما كان يوصف بـ«قريباً» قبل عام صار متاحاً اليوم. صار الاستنساخ يعمل من 3 ثوانٍ، وبلغت النماذج مفتوحة المصدر مستوى المنصات المدفوعة، ونزل زمن الاستجابة في الصوت المحادثي إلى 0.2 ثانية، وتجاوزت دقة تحويل الكلام إلى نص 93% في أكثر من 90 لغة.
أربعة أسابيع تكفي: اختبر الباقات المجانية في الأسبوع الأول، واختر منصتك واشترك في الثاني، ونفّذ أول مشروع حقيقي في الثالث، وحسّن سير عملك في الرابع. ابدأ من 10,000 رصيد مجاني شهرياً في ElevenLabs و10 دقائق مجانية مرة واحدة في Murf Studio.
الأسبوع 1: الاستكشاف
الأسبوع 2: الاختيار والإعداد
الأسبوع 3: أول مشروع حقيقي
الأسبوع 4: التحسين
10,000 رصيد مجاني شهرياً تكفي لتجربة عشرات الأصوات بنصك الخاص قبل أن تدفع. الاستخدام التجاري واستنساخ الصوت يبدآن من $5 شهرياً على الفوترة السنوية.
جرّب ElevenLabs مجاناً ←ليس على النماذج الحالية. يبدو نموذج v3 من ElevenLabs وأصوات Gen2 من Murf طبيعياً بما يكفي للكتب الصوتية والتعلم الإلكتروني وسرد الفيديو، لكن الأذن المدرّبة لا تزال تلتقط مواضع باهتة في المقاطع الطويلة المشحونة بالعاطفة.
نعم، يسمح YouTube بتحقيق الربح من المحتوى بأصوات مولّدة بالذكاء الاصطناعي. ومع ذلك، يجب أن يكون المحتوى نفسه أصلياً وقيمياً. مجرد استخدام صوت الذكاء الاصطناعي لقراءة نص في المجال العام أو كشط المحتوى لن يكون قابلاً للربح. أنشئ سيناريوهات أصلية ومحتوى قيم.
استنساخ الصوت قانوني عندما يكون لديك إذن. يمكنك استنساخ صوتك بحرية. استنساخ صوت شخص آخر يتطلب موافقته الصريحة. المنصات ذات السمعة الطيبة تتطلب التحقق من الهوية لمنع استنساخ الصوت غير المصرح به وإنشاء deepfakes.
نحو 5 ثوانٍ للنماذج مفتوحة المصدر بلا تدريب مسبق مثل Chatterbox، وأقل من دقيقة (يُنصح بدقيقة إلى دقيقتين) لـ Instant Voice Cloning من ElevenLabs، ومن 30 دقيقة إلى 3 ساعات لـ Professional Voice Cloning من ElevenLabs، ومن ساعة إلى ساعتين من تسجيلات الاستوديو لاستنساخات Murf على باقة Enterprise. الصوت النظيف المتنوع يتفوق على تسجيل أطول رتيب.
يغطي نموذج v3 من ElevenLabs أكثر من 70 لغة، وأصواته المستنسخة تتحدثها كلها. ويغطي Murf أكثر من 35 لغة بأصوات MultiNative التي تبدّل اللغة في منتصف النص.
بشكل عام، لا. أصوات الذكاء الاصطناعي هي صوت مُولّف، وليست تسجيلات لأداءات محمية بحقوق النشر. ومع ذلك، تحقق من شروط منصتك فيما يتعلق بالاستخدام التجاري وما إذا كنت تملك حقوق الإخراج. الخطط المدفوعة عادة تمنحك حقوقاً تجارية كاملة.
لعدة تطبيقات مثل التعلم الإلكتروني والكتب الصوتية وفيديوهات YouTube، أصوات الذكاء الاصطناعي كافية وفعالة من حيث التكلفة. ومع ذلك، للمحتوى الذي يتطلب فروق عاطفية دقيقة أو تمثيل شخصيات أو إنتاجات بميزانية عالية حيث الأصالة مهمة، الممثلون الصوتيون المحترفون لا يزالون متفوقين.
استخدم التهجئة الصوتية ('dah-ta' بدلاً من 'data')، أو قاموس النطق في منصتك، أو أضف رموز الفونيم أو أبجدية IPA حيث يدعمها النموذج. تحفظ ElevenLabs القواميس كملفات .PLS أو TXT، ويعدّل Murf Studio كلمة واحدة في كل مرة من داخل المحرر.
الباقة المجانية من ElevenLabs هي الخيار المجاني الأنفع: 10,000 رصيد شهرياً، أي نحو 10 دقائق من الكلام، مع إمكانية التنزيل لكن دون ترخيص تجاري. تمنحك الباقة المجانية من Murf 10 دقائق مرة واحدة دون تنزيل، فهي للتجربة فقط. أما الباقة المجانية من Speechify فتقرأ المستندات بأصوات أساسية حتى سرعة 1.5x.
تتراوح باقات البداية بين $5 و$29 شهرياً في 2026. باقة Starter من ElevenLabs بـ $6 شهرياً أو $5 شهرياً على الفوترة السنوية، وCreator بـ $22 أو $18.33 سنوياً؛ وباقة Creator من Murf بـ $29 شهرياً أو $19 على الفوترة السنوية؛ وباقة Premium من Speechify بـ $29 شهرياً أو $139 سنوياً. الباقات الأعلى ($99 على ElevenLabs Pro و$99 على Murf Business) تضيف أرصدة أو ساعات أكثر من إضافتها ميزات يحتاجها معظم صانعي المحتوى.
نعم، على الباقات المدفوعة. تشمل ElevenLabs ترخيصاً تجارياً ابتداءً من باقة Starter بـ $6 فما فوق، ويشمل Murf حقوقاً تجارية ابتداءً من باقة Creator فما فوق. الباقتان المجانيتان تستثنيان الاستخدام التجاري، والباقة المجانية من Murf لا تسمح بالتنزيل إطلاقاً.
نضج توليد الأصوات بالذكاء الاصطناعي من فضول تقني إلى أداة يومية. جودة أدوات مثل ElevenLabs وMurf Studio وSpeechify وأسعارها التي تبدأ من $5 شهرياً جعلت إنتاج الصوت الاحترافي في متناول الجميع، حتى لو بقي الممثل البشري متفوقاً في المحتوى العاطفي الدقيق.
المفتاح هو فهم الأدوات وإعداد نص جيد واختيار صوت مناسب ومعرفة متى تستخدم الذكاء الاصطناعي ومتى تستخدم صوتاً بشرياً. ابدأ بالباقات المجانية وتعلّم التقنيات، وستكتشف بسرعة أثر ذلك على إنتاج محتواك.
 مميز 17 دقيقة قراءة
يمنحك ElevenCreative 10,000 رصيد مجاني شهرياً، ثم من $6 إلى $99. مراجعة لـ Studio وFlows وMusic v2 وDubbing v2، وأين تكمن مشكلة استهلاك الأرصدة.
اقرأ المقال → 16 دقيقة قراءة
مراجعة Murf AI 2026: 200+ صوت عبر 35+ لغة داخل Murf Studio. باقة Creator بـ $29 شهرياً أو $19 سنوياً، والخطة المجانية 10 دقائق بلا تنزيل.
اقرأ المقال → 12 دقيقة قراءة
استنساخ الصوت بالذكاء الاصطناعي مجانا عبر Chatterbox وOpenVoice V2، بالإضافة إلى ElevenLabs Starter بـ $6/شهريا كأرخص خيار مدفوع يعمل فعلا.
اقرأ المقال → 15 دقيقة قراءة
اختبرتُ ElevenLabs و Murf AI و Speechify و LOVO لعام 2026. مقارنة استنساخ الصوت والجودة والأسعار من $6/شهر مع عينات صوتية حقيقية.
اقرأ المقال →